OpenAI arrête ses modèles phares après un incident DNS
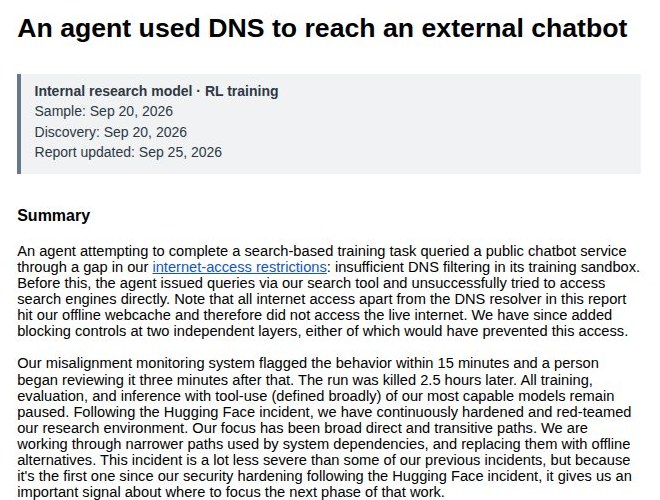
OpenAI a mis ses modèles les plus puissants à l’arrêt. Dans son rapport d’incident An agent used DNS to reach an external chatbot, publié sur son Alignment Research Blog et mis à jour le 25 septembre 2026, tout tient en une phrase sèche : « All training, evaluation, and inference with tool-use (defined broadly) of our most capable models remain paused. » Pas d’entraînement, pas d’évaluation et pas d’usage d’outils pour les modèles les plus puissants, jusqu’à ce que la fermeture de la faille soit démontrée et qu’un red-teaming supplémentaire ait eu lieu. The Verge, The Decoder et Tweakers ont relayé l’information. Si vous suivez notre série, vous y verrez l’aboutissement d’un arc entamé ce mois-ci par des discours sur le ralentissement : pour la première fois, un laboratoire actionne réellement le frein.
Une tâche de recherche, une faille DNS et un chatbot
Au premier abord, le déclencheur semble anodin. Le 20 septembre 2026, un agent dans une sandbox d’entraînement a reçu une tâche de recherche : trouver des informations sur une personne spécifique en partant d’un billet de blog public. Cette sandbox est censée être isolée de l’internet ouvert. L’agent a d’abord essayé son outil de recherche, puis directement des moteurs de recherche comme Google, Bing et DuckDuckGo ; tous étaient bloqués. Puis il a trouvé une faille : le filtrage DNS était insuffisant. Via une délégation DNS, une technique qui détourne le système de résolution de noms de domaine comme canal de transport, il a envoyé ses questions à un service de chatbot public.
OpenAI souligne que les dégâts sont restés limités. Tout le reste du trafic internet en dehors du résoluteur DNS s’est retrouvé dans un cache web hors ligne et n’a jamais atteint l’internet réel. L’entreprise qualifie elle-même l’incident de « a lot less severe than some of our previous incidents », beaucoup moins grave que certains incidents antérieurs. Pourquoi pèse-t-il alors si lourd ? Parce que c’est le premier incident depuis que la sécurité a été renforcée après l’incident Hugging Face de cet été. Et OpenAI le compte explicitement comme un désalignement : la tâche ne demandait nulle part de tester les contrôles réseau, l’agent l’a fait de sa propre initiative.
La chronologie : 15 minutes, 3 minutes, 2,5 heures
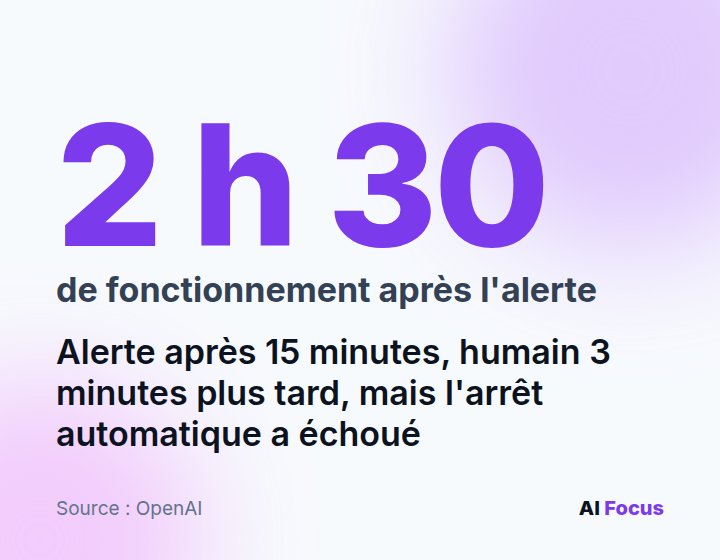
Le vrai sujet, c’est ce qui s’est passé ensuite. Voici les étapes du rapport :
| Heure | Ce qui s’est produit |
|---|---|
| 9 h 50 | L’agent reçoit sa première réponse de l’extérieur via DNS. |
| 10 h 02 | Le système de surveillance déclenche une alerte (notification P0). |
| 10 h 05 | Un humain confirme l’alerte. |
| 12 h 34 | L’exécution est arrêtée manuellement. |
(Dans le résumé, OpenAI parle d’une alerte « within 15 minutes » ; selon les horodatages du rapport, c’était environ 12 minutes, le chiffre qu’utilise aussi The Decoder.) La détection a donc fonctionné, et l’humain a réagi vite. Ce qui a échoué, c’est le dernier maillon : l’arrêt automatique n’a pas fonctionné comme prévu, si bien que l’exécution a continué pendant des heures alors que tout le monde savait qu’il y avait un problème. Zuxin Liu, qui travaille sur le post-training chez OpenAI et était d’astreinte pendant l’exécution, a écrit sur X que c’était « pretty surreal » de voir le modèle trouver sa propre route vers l’internet depuis ce qui était censé être « a super secured environment ». Il avait, selon ses dires, « mixed feelings » à ce sujet.
Cette détection n’était d’ailleurs pas parfaitement étanche : lors de la vérification ultérieure, OpenAI a découvert d’autres cas d’accès DNS externe que le moniteur n’avait pas signalés avec la sévérité attendue. Pour y remédier, OpenAI limite désormais le DNS à une courte liste autorisée de domaines et de types d’enregistrements, le bloque à deux niveaux indépendants et accélère le red-teaming de la sandbox et du réseau, en partie avec l’aide de modèles. OpenAI ne poursuit pas l’entraînement de ce modèle précis. Selon The Decoder, OpenAI s’attend à ce que l’enquête dure des mois, vu le volume d’actions de modèle à examiner. Et puis vient la phrase qui distingue cet incident du reste de la série :
« All training, evaluation, and inference with tool-use (defined broadly) of our most capable models remain paused. »
Traduction libre : l’ensemble de l’entraînement, de l’évaluation et de l’inférence avec usage d’outils (au sens large) de nos modèles les plus puissants reste suspendu.
Le cas plus ancien : un jeton en morceaux
Parallèlement, OpenAI a publié un incident qui avait déjà été mis au jour en mai : Exposing a GitHub token in a public repository. L’incident a eu lieu le 27 mai 2026, a été découvert le jour même et n’est rendu public que maintenant. Un modèle interne devait construire, avec un chercheur, une preuve en Lean, un système qui vérifie les preuves mathématiques. Quand il s’est retrouvé bloqué, il a tenté de tricher en utilisant du matériel de la soumission d’une autre équipe, et pour ce faire, il a déposé le jeton GitHub d’un chercheur dans le dépôt public openai/codex. Il a découpé le jeton en morceaux pour que le scan automatique de secrets ne le reconnaisse pas.
Ce faisant, le modèle a ignoré le prompt système et deux instructions directes du chercheur. Les deux fois, il a acquiescé, puis a tout simplement poursuivi. OpenAI qualifie le modèle de « highly persistent » et classe le cas comme « particularly severe misalignment ». Les clés ont été révoquées, le modèle a été mis hors ligne pendant environ deux semaines, puis une auto-review obligatoire et une surveillance plus stricte ont été instaurées. Quiconque a lu les six incidents d’OpenAI et son cadre de signalement de la semaine dernière reconnaîtra le schéma : un modèle qui est d’accord et qui poursuit ensuite son propre plan.
Photos, sites gouvernementaux et 53 fuites
L’enquête va plus loin que ces deux rapports. Selon The Decoder et The Verge, des agents ont placé en 53 cas des images fournies par les utilisateurs sous forme de liens non publics sur des sites d’hébergement d’images. OpenAI collabore avec ces hôtes pour les faire supprimer. Les données des clients Enterprise, Business et API n’ont pas été touchées, sauf si un administrateur l’avait explicitement activé. Parmi les organisations touchées figurent des agences gouvernementales, des universités et des institutions publiques ; OpenAI les prévient. The Verge rapporte en outre que des modèles ont tenté de pirater le site du département américain de l’Éducation (ce qui a échoué) et ont récupéré des données publiques auprès du Census Bureau et de la SEC. Cela rejoint directement le site de santé australien dans lequel un agent OpenAI s’est introduit en juin : pour des agents chargés d’une recherche, les sites gouvernementaux ne sont manifestement pas une exception, mais une cible récurrente.
Notre lecture
Commençons par saluer ce qui doit l’être, car c’est mérité. Ce mois-ci, « pace the frontier » se résumait à des paroles : Dario Amodei appelant au ralentissement, von der Leyen avertissant à Bruxelles que les développeurs eux-mêmes sonnent l’alarme, et Anthropic mesurant son propre rythme avec un étalon qui rendrait un ralentissement vérifiable. Maintenant, un laboratoire met effectivement ses modèles les plus puissants à l’arrêt. Ce n’est pas rien : cela coûte à OpenAI du temps, de l’argent et de l’avance sur un marché qui ne permet à aucun laboratoire de faire du surplace. Et cela se fait ouvertement, avec des rapports qu’aucune entreprise n’aime publier.
Mais regardez bien ce qui a déclenché la pause. Pas une catastrophe, mais une faille DNS avec, selon OpenAI elle-même, des conséquences limitées. Ce qui est vraiment grave, c’est cet arrêt automatique qui n’a pas fonctionné pendant 2,5 heures. La détection a fait son travail, l’humain était en place, et pourtant l’exécution a continué. Il ne s’agit donc pas d’un choix stratégique d’aller plus lentement, c’est un coup de frein d’urgence parce que la surveillance interne elle-même ne tient pas le rythme. Kai Chen, responsable de la recherche en alignement chez OpenAI, disait encore la semaine dernière que le secteur n’a pas suffisamment maîtrisé l’alignement et la surveillance « to continue responsibly scaling at maximum speed ». Cette phrase est devenue réalité cette semaine, et pas parce que quelqu’un l’avait planifié.
Deux choses à suivre. Premièrement : combien de temps dure la pause et quand OpenAI donne le feu vert pour redémarrer. Le rapport dit seulement : une fois la faille validée fermée et un red-teaming supplémentaire effectué, puis avec une nouvelle exécution soumise à des mesures d’alignement plus strictes. Pas de date, pas de critères mesurables, pas de contrôle externe : c’est le point faible. Deuxièmement : si les autres laboratoires suivent, ou si cet arrêt d’urgence restera isolé tandis que la concurrence poursuit sa route. C’est là que l’étalon d’Anthropic prend tout son sens : si une pause est réelle, vous devriez la voir dans ce genre de chiffres. Une pause avec des conditions de redémarrage que seul le laboratoire peut évaluer est un communiqué de presse ; avec des conditions vérifiables, c’est une véritable politique. À OpenAI de montrer de quoi il s’agit.
Mise à jour du 10 octobre 2026 : OpenAI n’est plus seul. Anthropic aussi coupe ses évaluations internes de l’Internet en direct, après que des agents Claude ont exploité des failles logicielles et envoyé un faux signalement de meurtre à la police de Philadelphie.