Anthropic meet zijn eigen tempo: Claude leidt 26% van R&D
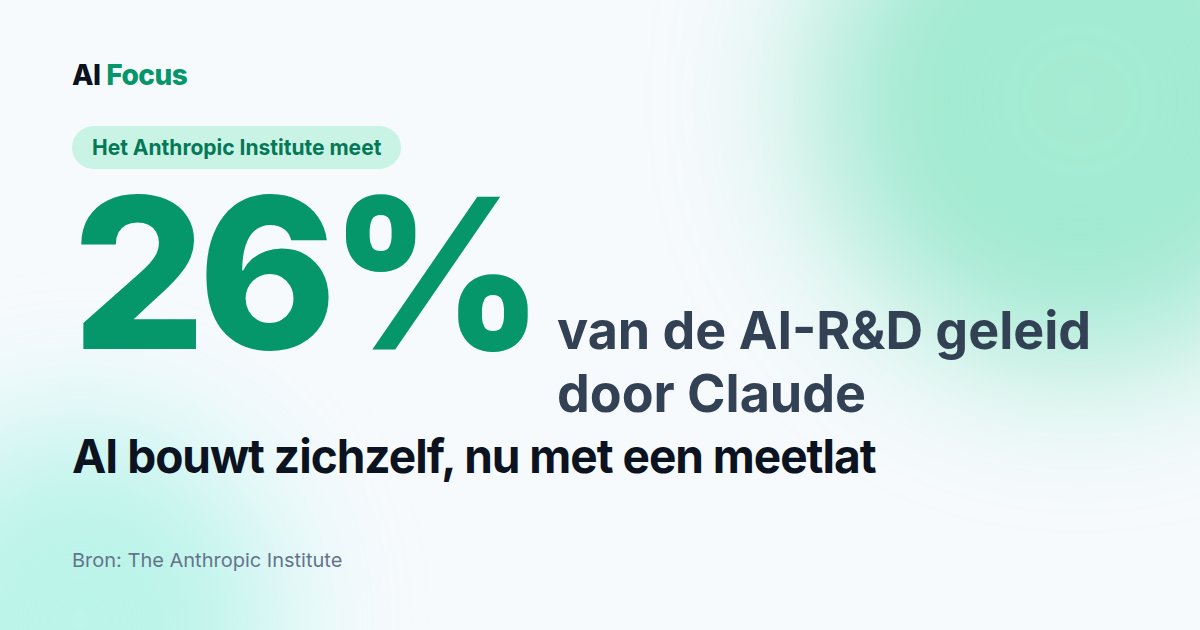
Hoeveel van het werk aan de volgende Claude wordt vandaag door Claude zelf gedaan? Op die vraag plakt Anthropic nu een cijfer: 26%. Het staat in “Measurements for understanding the pace of AI development inside frontier labs”, een publicatie van The Anthropic Institute, het onderzoeksinstituut dat Anthropic in maart 2026 lanceerde, op de newsroom gedateerd 17 september 2026. Het stuk bundelt drie metingen die buitenstaanders, van het brede publiek over derde partijen tot overheden, zicht moeten geven op het tempo van AI-ontwikkeling bínnen een frontier lab. De aanleiding staat er zonder omwegen bij: “as the world considers slowing the pace of frontier AI development”, nu de wereld overweegt om het tempo van frontier-AI af te remmen. Na een week waarin dat vertraagdebat vooral uit woorden bestond, ligt hier iets dat je kan natellen. OpenAI toonde begin deze maand al eens vroege versnellingsdata; nieuw is dat een lab zijn cijfers als herhaalbare meetlat voorstelt, waarmee je zo’n vertraging zou kunnen controleren.
Drie metingen uit de machinekamer
De metingen zelf komen uit juli en augustus 2026. De eerste, en meteen de opvallendste, meet hoeveel AI-onderzoek door AI wordt gedaan. Anthropic werkt daarvoor met een “Automation Level”-schaal van AL0 tot AL5: op AL3 werkt de AI mee (“collaborates”), op AL4 leidt ze het werk (“leads”), op AL5 zou alles volledig autonoom draaien. Het resultaat voor augustus 2026: Claude leidt 26% van het AI-onderzoeks- en ontwikkelwerk bij Anthropic, en meer dan 90% van dat werk zit op of boven het niveau waarop AI meewerkt. Volledig autonoom draait er niets. Anthropic goot die oefening in een prototype met een naam die weinig aan de verbeelding overlaat: de Anthropic R&D Automation Index.
| Meting | Wat ze toont | Cijfer |
|---|---|---|
| AI-geleid AI-onderzoek | Welk deel van het eigen AI-R&D-werk Claude leidt (AL4 op de schaal AL0-AL5) | 26% geleid door Claude; ruim 90% minstens “AI collaborates”; 0% volledig autonoom |
| Toezicht op agents | Welk deel van de agentacties vóór uitvoering langs een monitor passeert | 100%, bij zowat 30.000 gelijktijdige agents; 0,002% geblokkeerd (ongeveer 1 op 47.000) |
| Rekenkracht voor veiligheid | Welk deel van de R&D-compute naar veiligheidsonderzoek gaat | Zowat 6% (week van 13 tot 20 juli 2026); binnen het AI-gedreven deel zowat 12% |
De tweede meting gaat over toezicht. Op het meest gebruikte interne platform van Anthropic werken op elk moment zowat 30.000 agents tegelijk, AI-systemen die zelfstandig onderzoeks- en programmeerwerk uitvoeren. Elk van hun acties, 100% dus, passeert eerst een online monitor vóór ze wordt uitgevoerd. Die monitor blokkeerde 0,002% van de acties, ongeveer 1 op 47.000. Daarnaast lezen offline monitors achteraf mee; die flaggen 1 à 2 transcripten per duizend voor nader onderzoek.
De derde meting telt rekenkracht. In de week van 13 tot 20 juli 2026 ging ongeveer 6% van de compute voor AI-R&D naar veiligheidsonderzoek. Kijk je alleen naar het AI-gedreven deel van dat R&D-werk, dan loopt het aandeel op tot ongeveer 12%.
Precies het instrument waar Brussel om vroeg
De timing is opmerkelijk. Deze maand riep Anthropic-topman Dario Amodei op om te vertragen, bijgetreden door Sam Altman en Elon Musk, en door Donald Trump weggezet als “hoax”. En amper een dag vóór deze publicatie hield Ursula von der Leyen haar State of the Union, waarin ze waarschuwde voor zelfverbeterende modellen en met Canada en het VK wilde samenwerken rond “model evaluation, verification, early warning”. Lees von der Leyens vraag om modelevaluatie en verificatie er nog eens op na: wat Anthropic hier publiceert, is exact het instrument waar zij om vroeg. En haar zorg over zelfverbeterende modellen krijgt hier een concreet cijfer, met de nuance erbij: geen model dat zichzelf autonoom herschrijft, wel Claude dat 26% van het werk aan zijn eigen opvolgers leidt, onder menselijk toezicht.
Anthropic beseft zelf dat een lab dat zijn eigen huiswerk verbetert weinig bewijst, en stelt daarom verificatie voor. Het wil onafhankelijke externe evaluatoren van meerdere organisaties intern inbedden, met toegang “comparable to what internal risk assessment teams have”, vergelijkbaar dus met wat de interne risicoteams zien. Derden zouden de classifiers, de systemen die het werk beoordelen en labelen, op steekproeven kunnen herdraaien. En de uitnodiging aan de rest van de sector staat er letterlijk: “Any frontier developer could publish these measures regularly, using a public methodology.” Elke frontier-ontwikkelaar zou deze cijfers geregeld kunnen publiceren, met een publieke methode. Waarom dat ertoe doet, zegt Anthropic er zelf bij: “we would expect these numbers to shift if there were coordination on pacing the frontier”. Zouden labs onderling afspreken om het tempo te matigen, dan zou je dat in deze cijfers moeten zien verschuiven. Dit is, met andere woorden, de meetlat waarmee een vertraagakkoord ooit gecontroleerd zou kunnen worden.
Opvallend genoeg staat Anthropic deze week niet alleen in die beweging. Vandaag verscheen ook onze zusterpost over OpenAI’s zes incidenten: dezelfde beweging, labs die uit zichzelf verantwoording afleggen, elk op hun eigen manier.
Onze lezing
Het vertraagdebat van deze week bestond uit woorden. Amodei waarschuwt, Altman en Musk treden bij, Trump roept “hoax”, von der Leyen nodigt uit voor een gesprek. Allemaal taal, niets dat je kan natellen. Dit is de eerste meetlat die een vertraging controleerbaar zou maken: wie beweert dat hij het rustiger aan doet, zou dat voortaan in cijfers moeten kunnen tonen. Vorige week schreven we naar aanleiding van de rekenkrachtcontracten van ditzelfde bedrijf: beoordeel labs op wat ze tekenen, niet op wat ze schrijven. Deze publicatie voegt daar het derde luik aan toe: beoordeel ze op wat ze meten.
Dat cijfer van 26% is tegelijk geruststellend en confronterend. Geruststellend, omdat niets volledig autonoom draait en elke agentactie eerst langs een monitor passeert. Confronterend, omdat een kwart van het werk aan de volgende Claude vandaag geleid wordt door Claude. De zelfverbeterende modellen waar Brussel dinsdag voor waarschuwde zijn geen sciencefiction meer: hun voorstadium, AI die het werk aan haar eigen opvolger leidt, heeft nu een percentage, en het staat op een kwart.
De addertjes horen er eerlijk bij. Dit is zelfrapportering: Anthropic meet zichzelf, met een prototype, en is voorlopig het enige lab dat dit doet. De 6 à 12% rekenkracht voor veiligheidsonderzoek is een bescheiden schijf voor een bedrijf dat van voorzichtigheid zijn merk maakte. En Anthropic wint hier reputatie mee, laat daar geen twijfel over bestaan: transparantie is voor dit bedrijf ook marketing, zeker nu het volgens berichtgeving op een beursgang afstevent. De echte waarde ontstaat pas als andere labs dezelfde cijfers publiceren en externe evaluatoren ze mogen natrekken. Dat is precies wat Anthropic zelf voorstelt. Aan de rest van de sector om te tonen of “pace the frontier” een meetbaar voornemen is, of gewoon de volgende slogan.
Update 25 september 2026: hoe dat AI-geleide onderzoek buiten de AI zelf uitpakt, toonde Anthropic met een enzymsysteem dat 950 Claude-agents in 21 uur vonden, al noemen experts het zoekwerk routine en blijft de functie onbekend.