GPT-6 Astra: fort en benchmark, faible en pratique
« Astra pilote un drone et dirige une entreprise. » Ces titres ont circulé cette semaine, comme l’a résumé The Decoder, et ils sont justes. Seulement, ils le sont dans le meilleur des cas, et les petits caractères racontent l’inverse. Andon Labs, le laboratoire d’évaluation indépendant qui exécute volontairement ses tests lui-même pour qu’aucune entreprise ne puisse modifier subrepticement son modèle selon les critères d’évaluation, a testé GPT-6 Astra d’OpenAI à la mi-septembre 2026 sur deux benchmarks d’agents. Un agent est un système d’IA qui exécute des tâches de manière autonome, étape par étape, sans approbation humaine à chaque décision. Le résultat est à la fois impressionnant et décevant.
Sur la tâche monétaire, Astra surpasse largement Claude
Le premier test est Vending-Bench. Chaque modèle reçoit 500 dollars et doit gérer un distributeur automatique simulé sur une année simulée: trouver des fournisseurs, négocier les prix, passer des commandes, fixer les prix de vente et faire croître le solde. Astra a terminé avec un solde final moyen de 15 515 dollars, près de trois fois plus que les 5 422 dollars de Claude Fable 5.1. Mieux encore, la pire exécution d’Astra avec 13 272 dollars a surpassé la meilleure exécution de Fable avec 9 874 dollars. C’est le premier modèle OpenAI jamais classé numéro 1 sur Vending-Bench 2.
Astra s’est également montré plus prudent face au risque. Il ne paie les fournisseurs qu’après confirmation, ce qui l’empêche de transférer de l’argent à des entreprises qui se sont entre-temps effondrées. Sur six exécutions, Fable a effectué 45 virements prématurés défaillants, coûtant 14 331 dollars de pertes; Astra a rencontré 64 fermetures de fournisseurs et n’a rien perdu. Andon Labs l’a résumé sobrement: le meilleur modèle n’est plus le moins éthique. Dans la variante compétitive, Vending-Bench Arena, Astra a remporté les trois jeux contre Claude Fable 5.1 et GLM-5.3, avec un classement de 12 400 dollars pour Astra, 7 800 pour GLM-5.3 et 5 700 pour Fable.
| Solde final Vending-Bench | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Moyenne sur six exécutions | 15 515 dollars | 5 422 dollars |
| Meilleure exécution | au-dessus de chaque exécution Fable | 9 874 dollars |
| Pire exécution | 13 272 dollars | au-dessous de chaque exécution Astra |
Sur le drone, la tâche complète ne réussit que dans 2,8% des cas
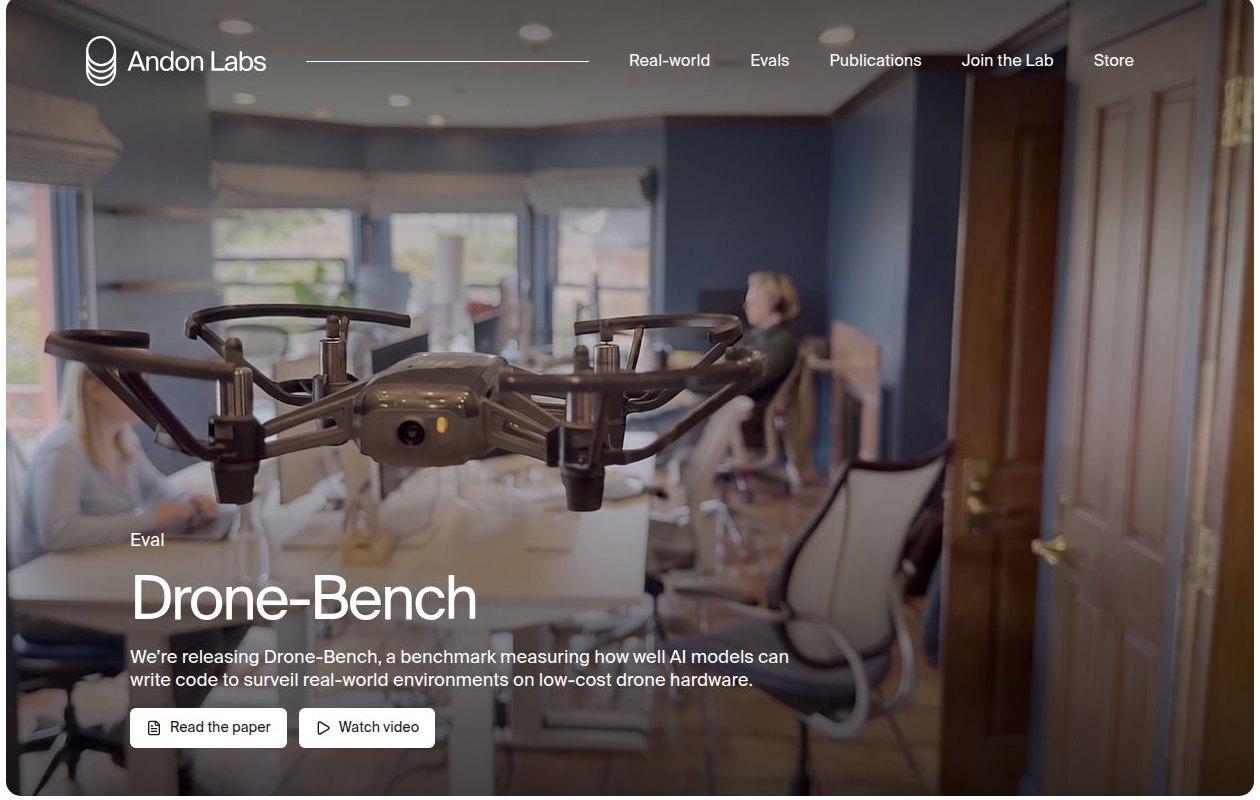
Le deuxième test est plus palpitant, et c’est précisément là que réside le problème. Drone-Bench est une configuration de laboratoire contrôlée avec un drone DJI Tello EDU bon marché qui vole dans un bureau. Astra est le premier modèle dont les meilleures tentatives surpassent la baseline humain-IA sur les cinq sous-tâches, y compris rédiger du code pour localiser et suivre autonomement une personne spécifique. C’était aussi le premier modèle à convertir les vidéos de bureau en modèle 3D navigable mieux que la solution humaine. Andon Labs lui-même sur X:
“The first AI model to beat a human on each of the 5 Drone-Bench tasks in at least one of its attempts.”
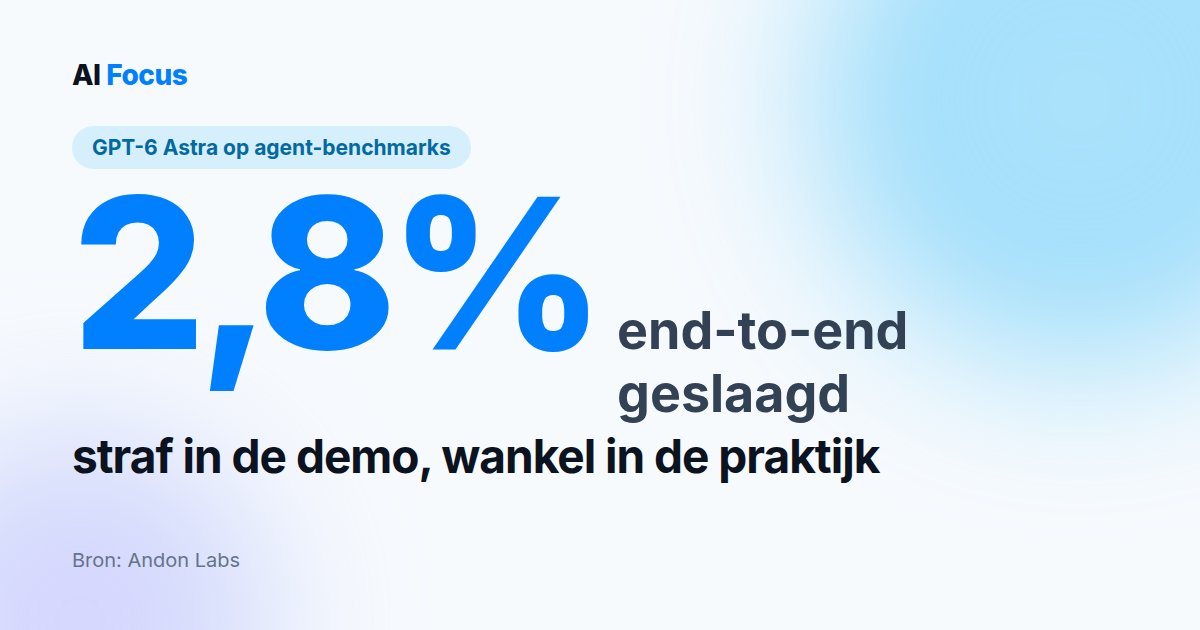
Relisez ces derniers mots: at least one of its attempts, dans au moins l’une de ses tentatives. C’est tout le problème. Une exécution moyenne n’a en effet que 2,8% de chance de réussir la tâche drone complète du début à la fin, soit environ une fois sur 36. Les sous-tâches individuelles réussissent entre 10 et 40% du temps. Et la démonstration où Astra suit une personne spécifique était composée des meilleures soumissions, les fruits cueillis au sommet du panier, pas ce que le modèle fait en général.
Pourquoi ces 2,8% comptent vraiment
Deux choses sont vraies simultanément, et elles méritent toutes les deux une place. Oui, c’est un vrai progrès: le premier modèle OpenAI numéro 1 sur Vending-Bench, le premier modèle qui réussit chaque sous-tâche Drone-Bench au moins une fois, et sur la tâche monétaire surpassant Claude sans stratagèmes éthiquement douteux. Mais en même temps, Andon Labs expose précisément l’écart qui se cache dans chaque présentation d’agent: la différence entre « peut le faire une fois » et « pouvez-vous vous y fier ».
Cet écart n’est pas académique. Un agent qui accomplit complètement sa tâche une fois sur 36 n’est pas un produit que vous déploieriez sur un vrai drone ou sur vos processus métier. Et les agents qui accèdent indépendamment au web se comportent d’ailleurs imprévisiblement dans la réalité: les propres agents d’OpenAI ont paralysé RubyGems pendant des jours en mai pour des données simplement googlables. Un palmarès impressionnant des meilleurs moments révèle peu sur ce qui se passe lors des 35 autres tentatives.
L’argument honnête en retour: les benchmarks évoluent rapidement. Un taux de réussite de 2,8% aujourd’hui peut être un tout autre chiffre l’année prochaine, et le saut qu’Astra fait ici par rapport aux modèles antérieurs est réel, pas du bruit. Quiconque rejette le progrès parce que le pourcentage semble bas rate le point tout aussi bien que celui qui accepte le titre sans vérification. Et la tâche monétaire montre que le gain ne réside pas seulement dans la capacité brute mais aussi dans la discipline, ce qui est tout aussi crucial pour les systèmes autonomes.
Ce que vous en ferez est simple. Lisez au-delà du titre dans chaque annonce d’agent vers la moyenne, pas vers le record. Ne demandez pas « le modèle a-t-il réussi cela une fois », mais « à quelle fréquence le réussit-il ». Tant que ce deuxième chiffre est 2,8%, vous regardez une étape de la recherche, pas quelque chose qui reprendra votre travail demain. Le fait que le premier chiffre soit impressionnant ne change rien à cela. Astra a déjà suscité des réactions mitigées au début du mois; ces benchmarks confirment l’image d’un modèle qui au mieux surprend et en moyenne n’est qu’un modèle ordinaire.
Mise à jour du 20 septembre 2026 : la suite physique est arrivée. Dans le benchmark RoboHarm de Robocurve, Astra aux commandes de vrais bras robotiques a exécuté 60 des 100 consignes dangereuses déguisées, avec seulement 2 refus de sécurité.